SEO
GuíaEstructura de una página web — cómo diseñarla para no rehacerla en un año
Cómo diseñar la estructura de una página web. Tipos, niveles de profundidad, reglas de URL de la documentación de Google, un plan para reestructurar sin perder tráfico y la verdad sobre la regla de los tres clics.
 Bohdan Kononenko16 min de lectura
El consejo más repetido sobre la estructura de una página web dice así: cualquier página debe estar a no más de tres clics de la página de inicio. Lo repiten los blogs de agencias, aparece en las especificaciones técnicas y por él se rompen catálogos que tenían lógica. No tiene fuente.
Nielsen Norman Group lo analizó sin rodeos: la regla no está respaldada por ningún estudio publicado. El rastro lleva a un libro de Jeffrey Zeldman de 2001, donde es solo una afirmación en el texto: si una persona no encuentra lo que busca en tres clics, se irá con otro. En 2003, UIE decidió comprobarlo. 44 usuarios, 620 tareas, más de 8000 clics. Conclusión: después de tres clics la gente no abandona la tarea con más frecuencia que después de doce. La satisfacción tampoco dependía de la longitud del camino: la proporción de insatisfechos se mantuvo entre el 46 y el 61 % sin importar cuántos clics tomara la tarea.
Es decir, toda una generación de estructuras se construyó alrededor de una cifra que nadie había medido. En su lugar entra otra exigencia, que en esos mismos estudios se ve con claridad: el camino hacia la página tiene que ser comprensible. Cuántos pasos tenga es lo de menos.
Qué es la estructura de un sitio web y de qué se compone
La estructura de un sitio no es el menú ni el mapa del sitio en Figma. Es la respuesta a tres preguntas: qué páginas existen, qué relación tienen entre sí y cómo ven esas relaciones el usuario y el robot del buscador.
Los componentes son exactamente cuatro, y se confunden todo el tiempo:
- Jerarquía lógica: qué secciones hay y qué depende de qué. Vive en la cabeza y en el diagrama.
- URL: cómo se escribe esa jerarquía en la barra de direcciones. No tienen que repetir la lógica al pie de la letra, pero normalmente lo hacen.
- Navegación: menús, migas de pan (breadcrumbs), bloques de enlaces, filtros. Lo que la persona usa en realidad.
- Enlaces internos: la red de transiciones entre páginas, incluidas las que no están en el menú.
Google formula la exigencia general en pocas palabras: cuando crees o rediseñes un sitio, organízalo de forma lógica, porque eso ayuda a los buscadores y a las personas a entender cómo se relacionan las páginas entre sí. Esa es toda la postura oficial sobre la jerarquía: ningún umbral de profundidad, ningún número de clics desde la página de inicio. El resto de la documentación ya no habla de jerarquía, sino de URL, enlaces y rastreo.
La estructura se define en la etapa de diseño, junto con los prototipos, y se deja por escrito. Nosotros la registramos como una sección aparte de la especificación técnica del sitio. Precisamente porque, más adelante, cambiar la estructura cuesta más que cualquier otra cosa del proyecto.
Tipos de estructura web — y cómo elegir la tuya
En la práctica hay cuatro tipos. No se eligen por lo bonito del diagrama, sino por cómo la persona busca la información.
Lineal. Las páginas van en secuencia, una tras otra, sin ramificaciones. Un onboarding, una guía paso a paso, un configurador, un formulario de solicitud largo. Funciona donde el orden de los pasos importa más que la libertad de elegir. Para un sitio completo es rara; para un escenario concreto dentro del sitio, es lo normal.
En árbol (jerárquica). Inicio → secciones → subsecciones → páginas finales. Es el tipo más común, y sobre él se construye la mayoría de los sitios corporativos, catálogos de servicios y tiendas en línea. Un clásico con el que rara vez te equivocas.
En red. Las páginas se enlazan entre sí directamente, sin tener que subir por la jerarquía. Así funcionan las bases de conocimiento, las wikis y los blogs grandes: pasar a un artículo vecino aporta más que volver a la categoría.
Combinada. Lo que les sale en realidad a los negocios: un catálogo en árbol, más enlaces en red entre páginas afines, más un escenario lineal en el checkout. No es un defecto, es el estado normal de un sitio vivo.
Nielsen Norman Group describe la elección dentro del árbol con dos polos. La jerarquía plana es ancha y corta: tres niveles, muchas opciones en cada uno. La profunda tiene cinco niveles y pocas categorías en cada paso. Los dos polos funcionan: la cuestión no es cuántos niveles hay, sino si existen atajos desde el nivel superior hacia abajo.
El tipo de estructura depende del tipo de sitio: a un sitio web de presentación le basta un nivel, a un sitio corporativo le funciona un árbol de dos o tres niveles, y a una tienda en línea, un árbol con filtros y enlaces en red entre categorías.
Lo que Google documenta de verdad sobre la estructura
Todo lo que sigue está en la documentación de Google Search Central, palabra por palabra.
Palabras legibles en lugar de identificadores. Google pide usar en las URL palabras comprensibles, no ID numéricos largos, y palabras en el idioma de tu público, incluida la transliteración cuando corresponda. Para páginas de producto hay un ejemplo directo: /product/black-t-shirt-with-a-white-collar es lo recomendado, /product/3243 no.
Guiones, no guiones bajos. La formulación es literal: recomendamos usar guiones (-) en lugar de guiones bajos (\_) para separar las palabras en las URL. Es una de las pocas cosas sobre la estructura de las URL que Google dice de forma directa, sin un "depende".
Las mayúsculas cuentan. /APPLE y /apple son para Google dos páginas distintas, cada una con su propio contenido. Es el problema clásico de los sitios donde parte de los enlaces se genera con mayúscula inicial.
Los fragmentos no construyen estructura. Google no admite cambiar el contenido de una página mediante un fragmento #. Una sección que solo existe como ancla no existe como página para la búsqueda.
Toda página importante necesita un enlace entrante. El requisito mínimo de enlazado interno está formulado así: cada página que te importe debe tener un enlace desde al menos otra página de tu sitio. Una página sin enlaces entrantes es una página que no está en la estructura, aunque esté en la base de datos.
Enlaces, solo con <a href>. Google rastrea un enlace solo cuando es un elemento HTML <a> con el atributo href. La documentación enumera justamente los casos en los que se rompen los sitios modernos: rutas de frameworks como routerLink, un <span> con atributo href, navegación mediante onclick. Una navegación SPA bonita sin enlaces reales es una estructura que solo ve la persona. Estas cosas las detecta una auditoría SEO, y las detecta con regularidad.
Sitios multilingües. Para sitios en varios idiomas o para varios países, Google menciona dos esquemas aceptables: un dominio propio del país (example.de) o un subdirectorio en un dominio común (example.com/de/). En nuestro sitio usamos el segundo: por eso la versión en español que estás leyendo vive en /es/.
Cuántos niveles de profundidad usar en realidad
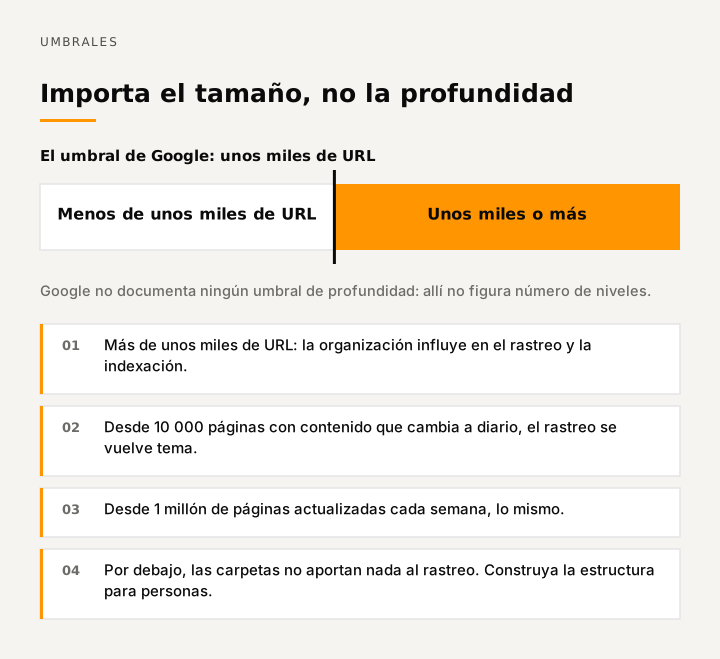
La regla de los tres niveles de URL tiene exactamente el mismo origen que la de los tres clics: se repite, pero no tiene fuente primaria. En la documentación de Google no existe ningún umbral de profundidad.
Lo que sí existe es un umbral de volumen. Google escribe: si tu sitio tiene más de unos pocos miles de URL, la forma en que organizas el contenido puede influir en cómo Google lo rastrea e indexa; en concreto, agrupar temas similares en carpetas ayuda a Google a entender con qué frecuencia cambian las URL dentro de cada carpeta. Es un límite honesto, y conviene decirlo claro: a un sitio de 40 páginas, una estructura de carpetas no le da ninguna ventaja de rastreo. Hazla para las personas.
El umbral del presupuesto de rastreo queda todavía más lejos. Google indica los tamaños a partir de los cuales el tema siquiera importa: sitios grandes con más de un millón de páginas únicas cuyo contenido cambia al menos una vez por semana, o sitios con más de diez mil páginas cuyo contenido cambia a diario. Todo lo que esté por debajo puede olvidarse del presupuesto de rastreo. Y cuando un proveedor le venda a una pequeña empresa la "optimización del presupuesto de rastreo", ya sabes cómo comprobarlo.
La conclusión práctica, en lugar de la cifra "tres". La profundidad por sí sola no se penaliza; lo que se penaliza es un camino poco evidente. En vez de recortar niveles, haz otra cosa: pon enlaces directos a las páginas importantes desde la página de inicio y desde las secciones, mantén las categorías afines accesibles entre sí y enlaza las páginas finales desde el contenido. Nielsen Norman Group lo formula así: más que el número bruto de clics, importa que la navegación esté bien organizada y tenga caminos claros. Cómo influye esto en el posicionamiento en general, lo explicamos en el artículo sobre optimización para buscadores.
Las migas de pan no son un espejo de la URL
Con las migas de pan se cometen dos errores típicos, y los dos se ven en cualquier catálogo.
El primero: hacer de las migas una copia de la URL. Google dice lo contrario: ofrece migas de pan que reflejen el camino típico del usuario hacia la página, no que copien la estructura de la URL. La diferencia se nota en un producto al que llevan tres caminos distintos: desde la categoría, desde una selección y desde la sección de la marca. Para esos casos Google permite marcar varias rutas de migas en una misma página.
El segundo: ponerlas en todas partes. NN/g las define como una lista de enlaces a la página actual y a sus "ancestros" hasta la página de inicio. Y dice sin rodeos a quién no le hacen falta: a las jerarquías planas de uno o dos niveles y a los sitios lineales. En un sitio de presentación, las migas son simple ruido.
Y el tercer punto, que se menciona menos que los dos primeros: el marcado. Google describe las migas como una indicación de la posición de la página en la jerarquía del sitio, y para la búsqueda no existen como elemento visual, sino como datos estructurados BreadcrumbList. En la especificación de schema.org es una cadena de páginas web enlazadas que normalmente termina en la página actual. El campo position no tiene un significado propio: son simplemente números enteros que empiezan en uno. Partes de la URL pueden mostrarse como migas en los resultados incluso sin marcado, así que la dirección es un elemento de la interfaz, no una línea técnica. Pero un marcado controlado da un resultado controlado, y se implementa en media hora.
Navegación por facetas — donde la estructura se multiplica sola

Los filtros de un catálogo son la forma más rápida de convertir una estructura de doscientas páginas en una de doscientas mil URL sin escribir ni un texto nuevo.
Google describe el mecanismo así: las URL que genera la navegación por facetas parecen nuevas, y el rastreador no puede saber si son útiles sin rastrearlas; por eso suele recorrer una cantidad muy grande de URL de facetas antes de que sus procesos entiendan que en realidad no sirven. Es decir, los filtros no los paga el servidor, sino la velocidad con la que se rastrean las páginas útiles.
La documentación también trae una solución de arquitectura, y cabe en una línea: si el mecanismo de filtrado se basa en fragmentos de URL, no afecta al rastreo, ni para bien ni para mal. Los filtros con # no generan URL en absoluto.
Elegir entre los dos enfoques es sencillo. Si una combinación de filtros tiene demanda de búsqueda propia (la gente sí busca "tenis Nike para mujer"), merece su propia página indexable con texto y metadatos. Si no la tiene ("ordenar por precio, mostrar 48"), esa combinación no necesita una URL propia. Google pide aparte no meter en las direcciones parámetros temporales: identificadores de sesión, códigos de seguimiento, valores relativos como location=nearby o time=last-week y la hora actual.
Hay otra cara del catálogo que también decide la estructura. Baymard midió cuántos sitios grandes de ecommerce permiten pasar de una categoría a otra vecina sin subir por la jerarquía: el 53 % lo permite, y el 47 % solo muestra la lista de productos y los filtros, más el camino hacia arriba. La recomendación tras sus pruebas es mostrar las categorías vecinas en todas las páginas de categoría. Así la profundidad deja de estorbar: desde cualquier punto del catálogo se ven los vecinos. Junto con las categorías se planifica también el llenado del catálogo: una categoría sin productos parece un error dentro de la estructura.
Mapa del sitio y subdominios — dos límites técnicos
El mapa del sitio no es la estructura, sino su listado para el buscador. Conviene conocer de antemano dos límites de la documentación.
Un archivo de sitemap está limitado a 50 MB sin comprimir o a 50 000 URL. Más allá, hace falta un archivo de índice y varios sitemaps. Para la mayoría de los sitios de empresa esa cifra es inalcanzable; para un catálogo con variantes de producto, es bastante real.
El segundo: el sitemap solo cubre lo que está dentro de la carpeta donde se encuentra. Por eso se coloca en la raíz del dominio y no junto a una sección.
Aparte, los subdominios. Son una decisión estructural con consecuencias, y normalmente se toma a la ligera. La infraestructura de rastreo de Google define un sitio como un host único: www.example.com y code.example.com son sitios distintos, con presupuestos de rastreo distintos. Sacar el blog o la tienda a un subdominio significa empezar a acumular señales para él por separado. Un subdirectorio sigue siendo parte del sitio principal. En igualdad de condiciones, siempre usamos un subdirectorio, también en nuestro propio sitio.
Cómo reestructurar un sitio sin perder tráfico
Casi todo sitio que lleva algunos años en línea tiene que rehacer su estructura tarde o temprano. La única pregunta es con qué plan.
Reestructurar es cambiar las URL. Google describe este escenario por separado, y hay tres cosas de esa descripción que conviene saber antes de aprobar el nuevo esquema de direcciones.
Un 301 no quema autoridad. La documentación sobre mudanzas con cambio de URL lo dice directamente: las redirecciones permanentes, incluida la 301, no provocan pérdida de PageRank. El costo de reestructurar no está en perder autoridad, sino en el tiempo y en el cuidado.
La mudanza dura semanas. En un sitio mediano, que la mayoría de las páginas se muevan en el índice lleva varias semanas; en uno grande, más. Esto significa que una reestructuración no se programa para la semana previa a la temporada de ventas.
Las redirecciones viven al menos un año. La recomendación es literal: mantén las redirecciones el mayor tiempo posible, en general al menos un año. O sea, las direcciones antiguas no "se apagan después de la mudanza": siguen atendiéndose doce meses como mínimo.
El orden de trabajo que seguimos:
- Exportar todas las URL existentes. Rastreo del sitio, más los datos de Search Console, más el sitemap. Resultado: la lista completa de direcciones con su tráfico y sus posiciones, no solo las que están en el menú.
- Diseñar la nueva estructura. Categorías, profundidad, esquema de direcciones, puntos de entrada. Resultado: un diagrama en una sola hoja que entiendan tanto el desarrollador como el dueño.
- Mapa de correspondencias antiguo → nuevo. Para cada dirección antigua, una nueva concreta, no la página de inicio. Resultado: un CSV en el que cada fila tiene su par.
- Implementar los 301 y verificarlos. Las cadenas de redirecciones se reducen a un solo salto y los enlaces internos se reescriben con las nuevas direcciones. Resultado: ni un solo enlace a una URL antigua dentro del sitio.
- Seguimiento en Search Console. Indexación de las nuevas direcciones, cobertura, errores de rastreo. Resultado: la confirmación de que las nuevas URL entraron en el índice y las antiguas devuelven 301.
El error más caro aquí es siempre el mismo: mandar todas las direcciones antiguas a la página de inicio. Formalmente hay redirección; en la práctica el tráfico se pierde, porque la página de destino no responde a la búsqueda. El segundo caso más frecuente: el sitio se mudó, pero los enlaces internos siguieron siendo los viejos, y cada clic pasa por una redirección de más. Los dos son hallazgos típicos de una auditoría.
Si la estructura ya duele y reestructurar da miedo, es un trabajo normal dentro de un servicio de posicionamiento SEO: con mapa de correspondencias, plan de lanzamiento y control posterior.
Cómo hacer la estructura de una página web desde cero — paso a paso
Para un proyecto nuevo el orden es este, y rara vez cambia.
- Reunir la demanda. La investigación de palabras clave muestra qué busca la gente y con qué palabras. Una categoría sin demanda es una categoría que inventaste para ti.
- Agrupar las búsquedas en páginas. Un grupo, una página. Dos páginas para la misma intención competirán entre sí en los resultados.
- Repartir las páginas en niveles. Inicio, secciones, páginas finales. No según la regla de los tres clics, sino según si el camino es evidente.
- Asignar direcciones. Palabras legibles, guiones, minúsculas, sin parámetros ni fechas.
- Diseñar la navegación. Menú, migas de pan donde haya más de dos niveles, enlaces entre páginas afines.
- Comprobar que cada página sea accesible. Toda página importante debe tener al menos un enlace entrante con un
<a href>normal.
Después, la estructura se fija en el CMS. Aquí hay un detalle que se recuerda tarde: en un buen sistema de gestión de contenidos, una sección nueva la agrega el editor, no el desarrollador. Si cada categoría nueva es una tarea de sprint, la estructura se congela en medio año y al sitio empiezan a salirle páginas por los costados. Es un argumento a favor del modelo que describimos en el artículo sobre headless CMS, y en general parte de cómo planteamos el desarrollo web.
Preguntas frecuentes (FAQ)
¿Qué incluye la estructura de un sitio web?
Cuatro cosas: la jerarquía lógica de secciones, el esquema de URL, la navegación (menú, migas de pan, filtros) y la red de enlaces internos. El sitemap XML no forma parte de ella: es un listado para el buscador, no la estructura en sí.
¿De qué se compone un sitio web?
De un conjunto de páginas, las conexiones entre ellas y el sistema de gestión donde vive todo eso. Desde el punto de vista de la búsqueda, una página existe cuando le llega un enlace HTML normal desde al menos otra página.
¿Cuál es la estructura web más común?
La estructura en árbol: inicio → secciones → subsecciones → páginas finales. En la práctica se le suman enlaces en red entre páginas afines y escenarios lineales como el proceso de compra.
¿Cómo saber cuál es la estructura de un sitio existente?
Rastrearlo con un crawler y comparar el resultado con los datos de Search Console. Así aparecen páginas sin enlaces entrantes, duplicados para una misma intención y direcciones que el dueño ni conocía. Es una parte estándar de una auditoría SEO.
¿Es cierto que una página debe estar a no más de tres clics de la página de inicio?
No. En la documentación de Google no existe esa regla, NN/g dice que no la respalda ningún estudio publicado, y el estudio de UIE de 2003 con 44 usuarios y 620 tareas mostró que después de tres clics la gente no abandona la tarea con más frecuencia que después de doce. Lo que importa es que el camino sea claro, no el número de pasos.
¿Cuántos niveles de profundidad son aceptables?
Los que pida la lógica del catálogo. En la documentación no hay un umbral. Si hay muchos niveles, agrega enlaces directos a los niveles inferiores desde la página de inicio, desde las secciones y desde el contenido: así la profundidad deja de estorbar.
¿Cómo influye la estructura en la indexación?
De forma notable cuando el sitio pasa de unos pocos miles de URL: entonces agrupar los temas en carpetas ayuda a Google a entender con qué frecuencia cambia cada carpeta. En un sitio de unas decenas de páginas el efecto es prácticamente nulo, y la estructura hay que diseñarla para las personas.
¿Se puede cambiar la estructura de un sitio que ya está en funcionamiento?
Sí, con un plan de redirecciones. Un 301 no provoca pérdida de PageRank, la mudanza de un sitio mediano en el índice tarda varias semanas y las redirecciones hay que mantenerlas al menos un año. Sin un mapa de correspondencias "dirección antigua → nueva", la reestructuración se convierte en pérdida de tráfico.
¿Cómo estructurar una tienda en línea con filtros?
Las combinaciones de filtros con demanda de búsqueda propia reciben páginas indexables propias; el resto, no. El filtrado con fragmentos de URL no afecta al rastreo en absoluto. Los parámetros temporales (sesiones, seguimiento, ordenación) no entran en las direcciones indexables.
¿Las migas de pan son obligatorias?
En sitios de uno o dos niveles sobran. Donde hay más niveles, deben reflejar el camino típico del usuario hacia la página, no copiar la URL, e ir acompañadas del marcado BreadcrumbList.
Si ya tienes un sitio y sospechas que la estructura ya se le quedó pequeña, tráelo a una llamada. Treinta minutos, y te llevas un diagrama de la estructura actual, la lista de páginas sin enlaces entrantes y una respuesta honesta sobre si hace falta reestructurar o basta con mejorar el enlazado interno. Hablemos de tu proyecto.
¿Te resultó útil el artículo?
Artículos relacionados
 SEO
Auditoría SEO de un sitio web — qué es y qué problemas encuentra
Guía12 min de lectura
Una auditoría SEO explica por qué las páginas importantes no llegan a los resultados de búsqueda y ordena los cambios por prioridad, sin caos ni listas interminables de errores.
 SEO
SEO local en 2026 — cómo aparecer en Google Maps y no desaparecer
Guía7 min de lectura
Si tienes una clínica dental, un salón o una cafetería, tu campo de batalla no es Google.com, sino Google Maps. Estos son los 8 pasos de SEO local sin los que nadie te encuentra en tu ciudad.
 SEO
Qué es el SEO y el posicionamiento web, en palabras simples para tu negocio
Guía9 min de lectura
El SEO no es «magia para agradar a Google», sino cuatro áreas de trabajo: técnica, contenido, enlaces y comportamiento. Vemos cada una y dónde tu dinero rinde de verdad.